 Falabella
0%de sus piezas en Meta decían Cyber
28 seppico: 155 piezas / día7 oct
- 56%
 44%
 30%
Falabella apagó la mitad en 48 horas.
Paris no apagó nada.
Leímos 3.899 creativos de seis retailers con dos modelos distintos, Jev y Clef, y los seguimos durante los tres días del evento. Esto no es cuánto invirtió cada uno: es qué le pedía cada pieza a la persona que la vio, y cuánto duró encendida.
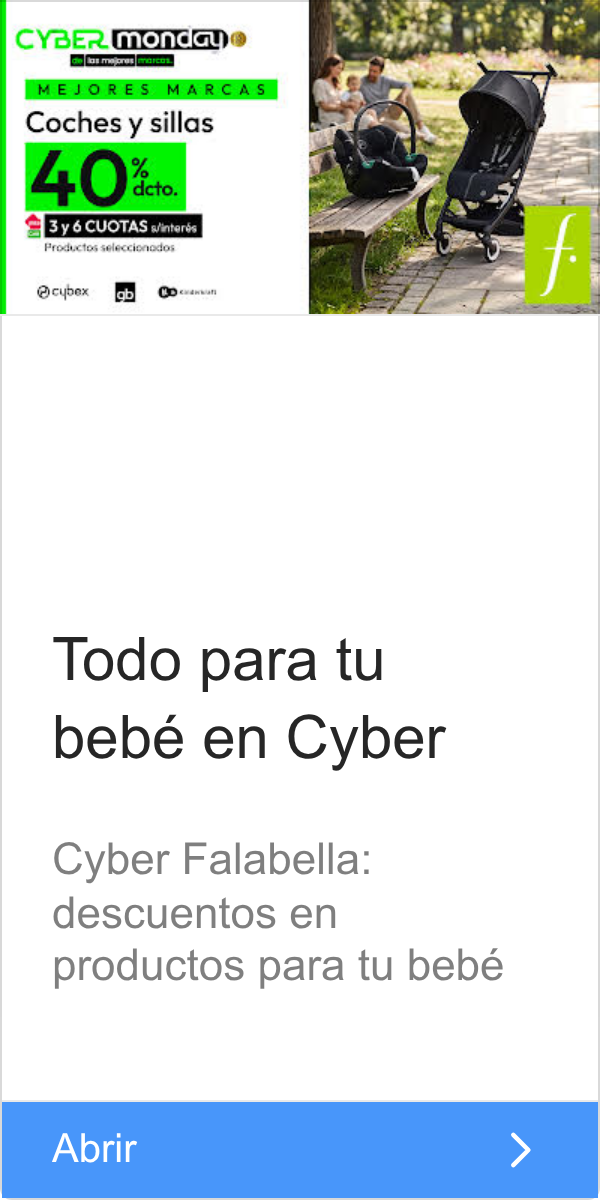
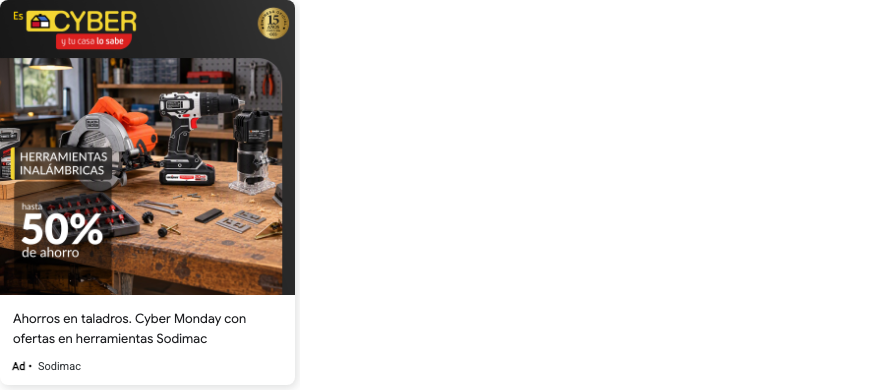
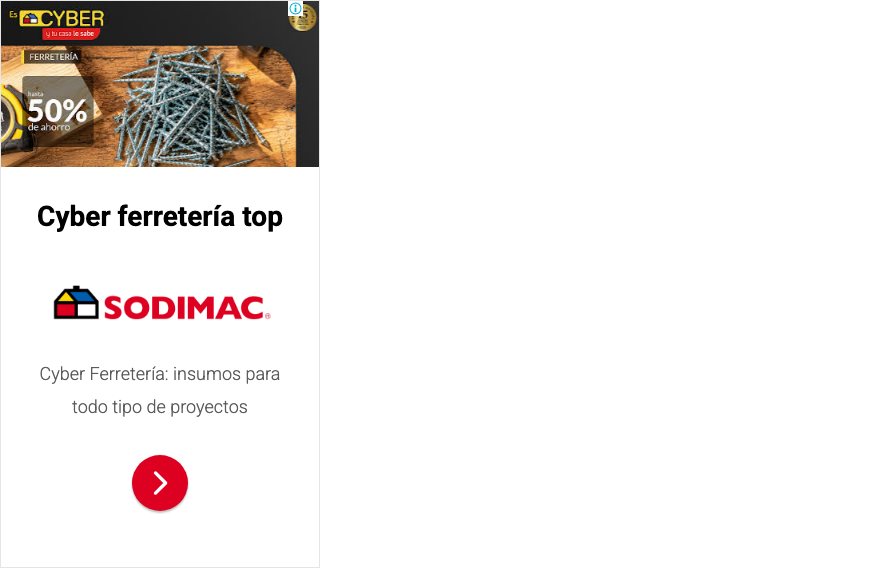
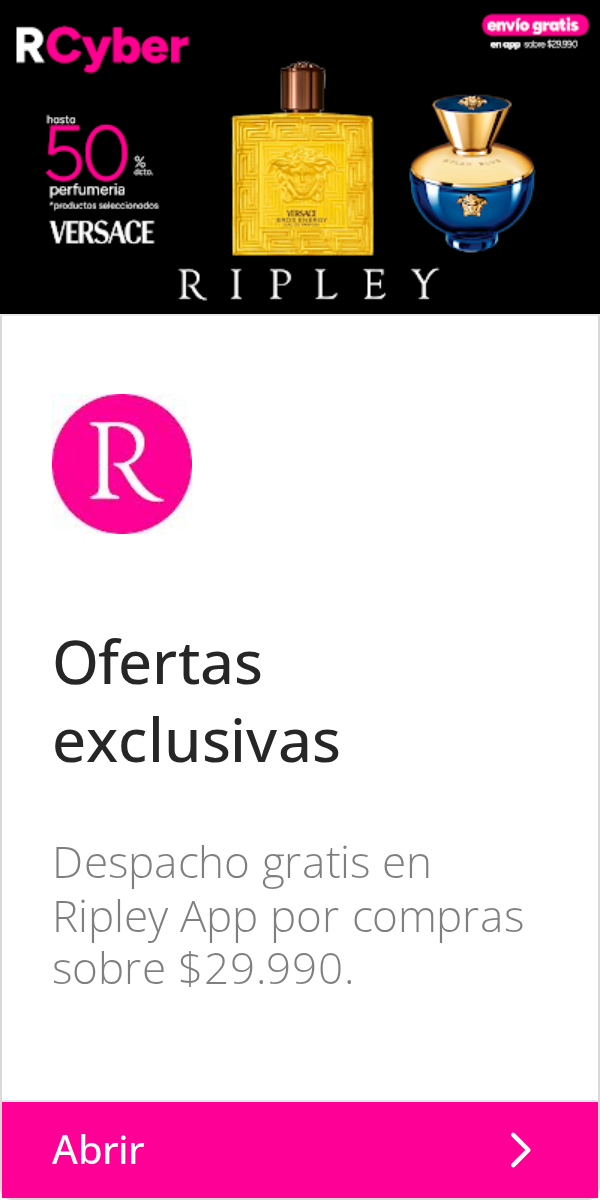
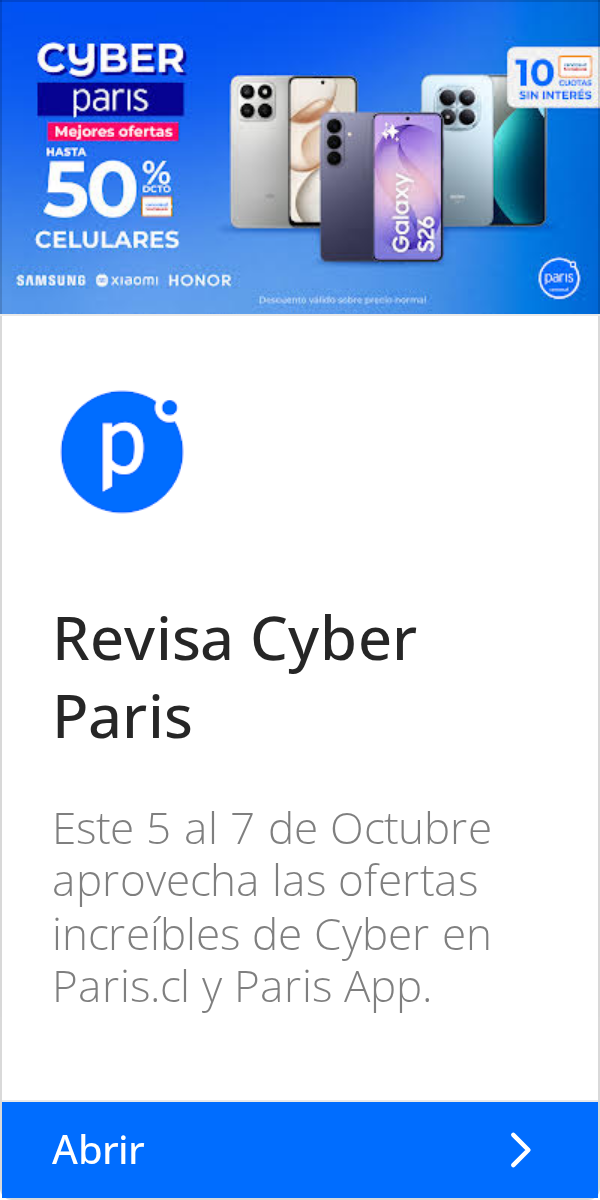
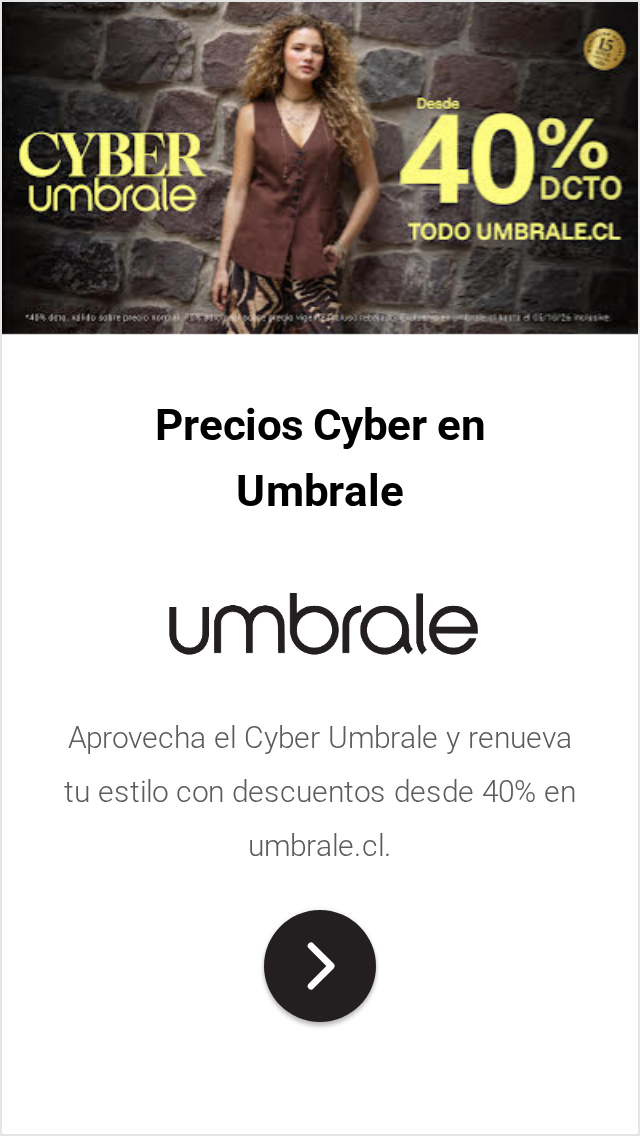
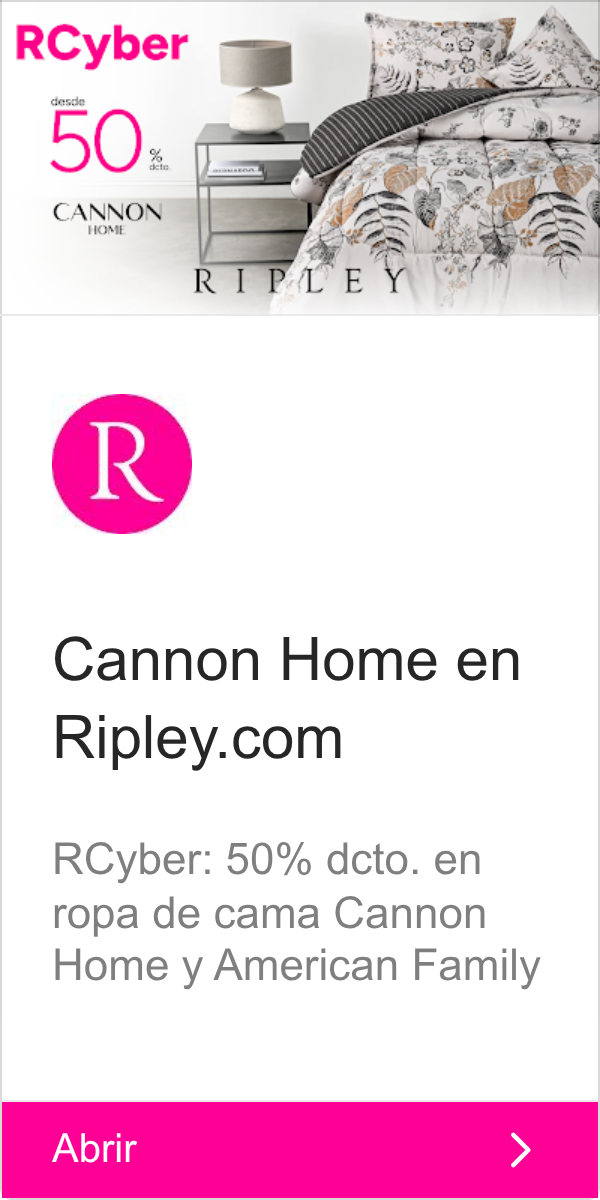
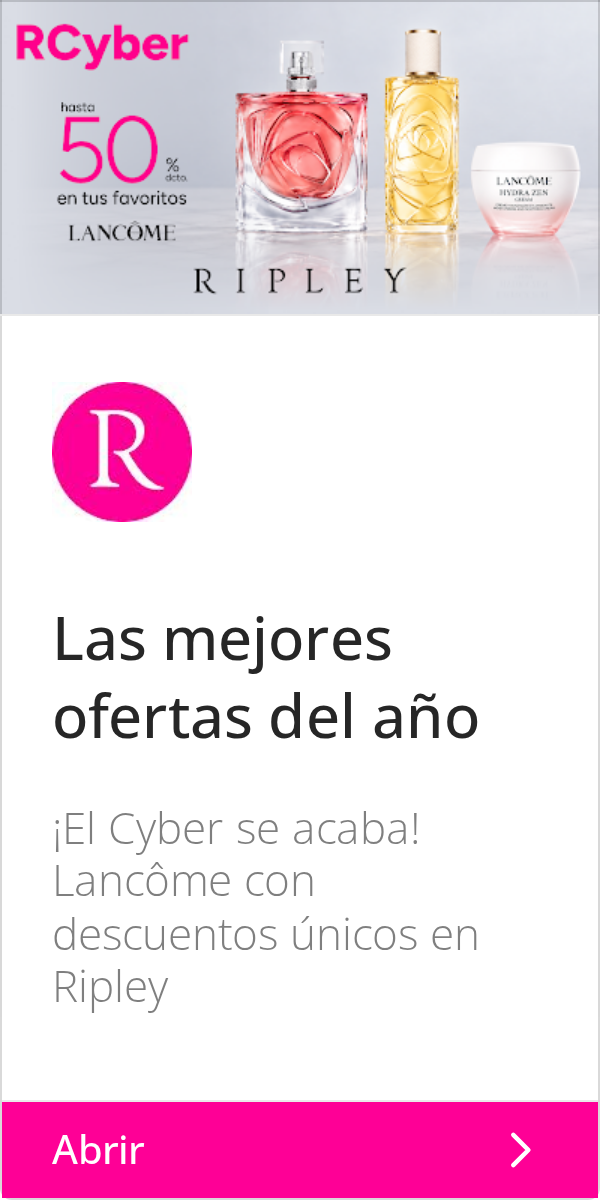
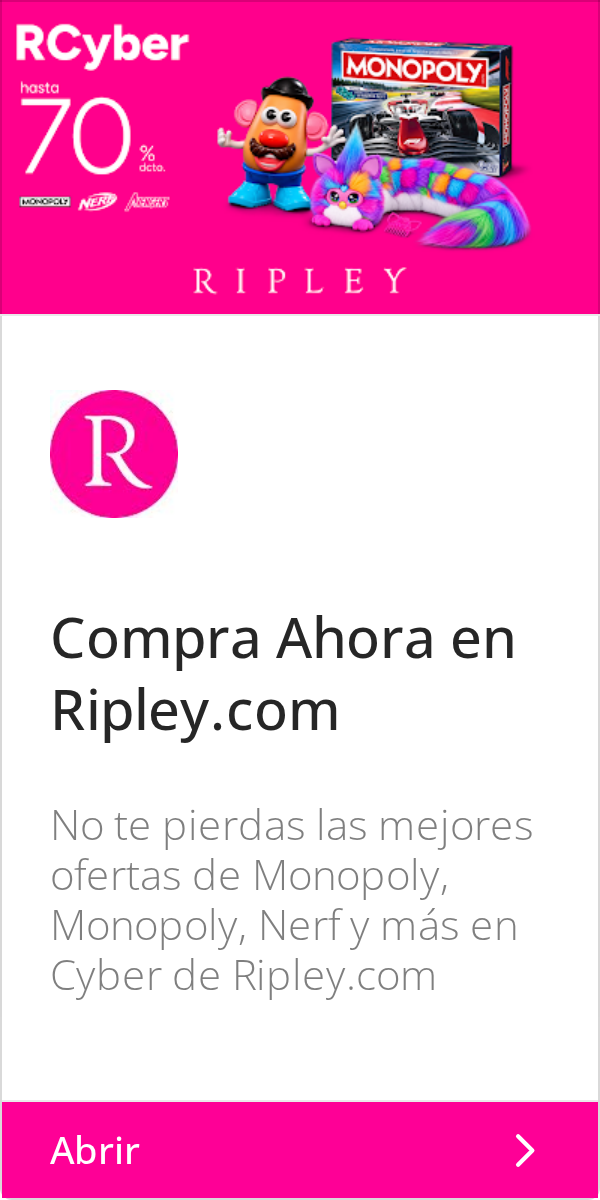
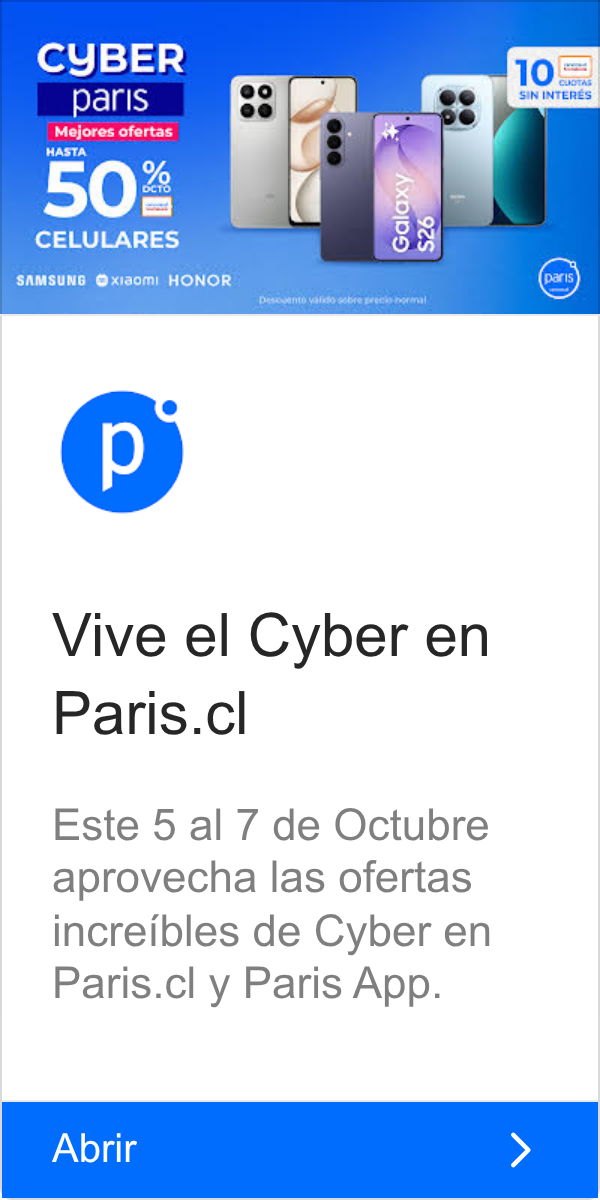
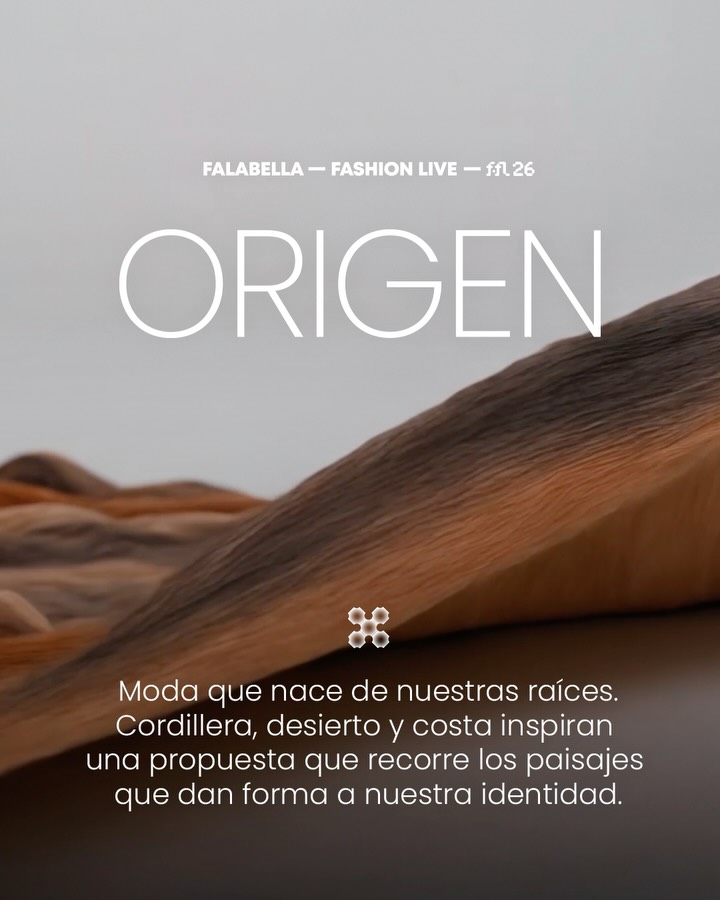
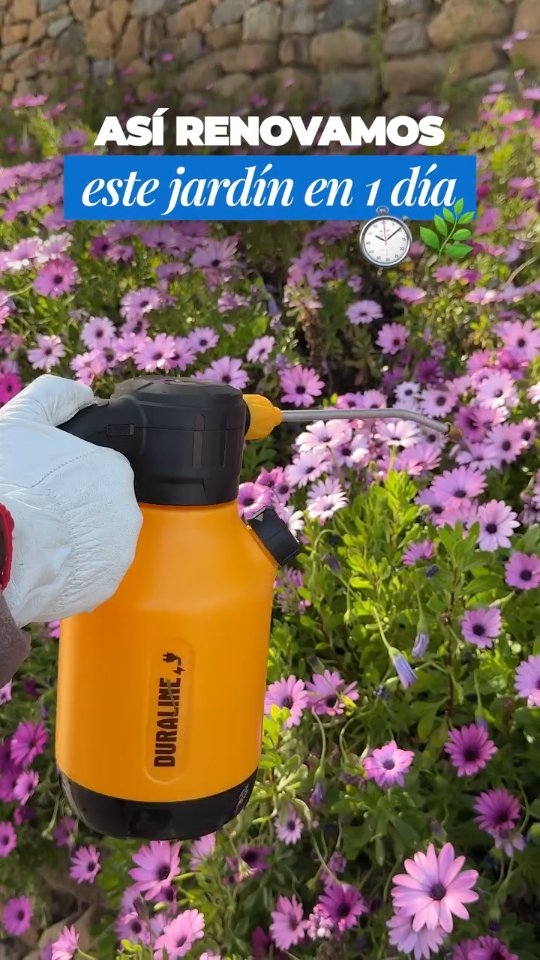
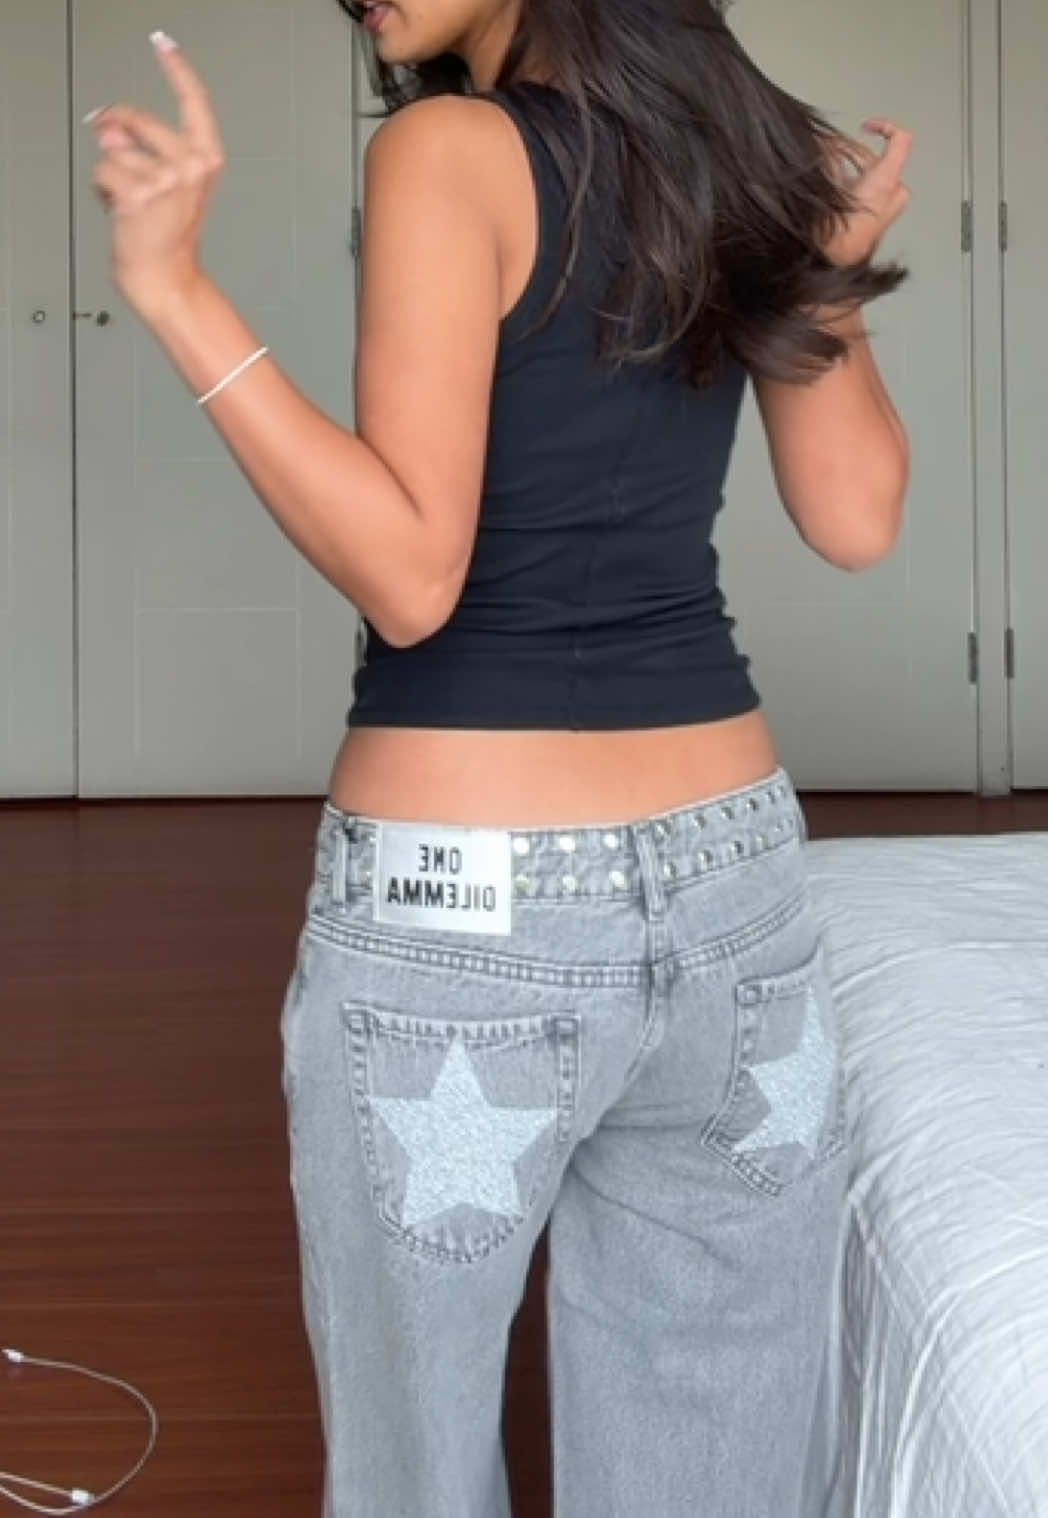
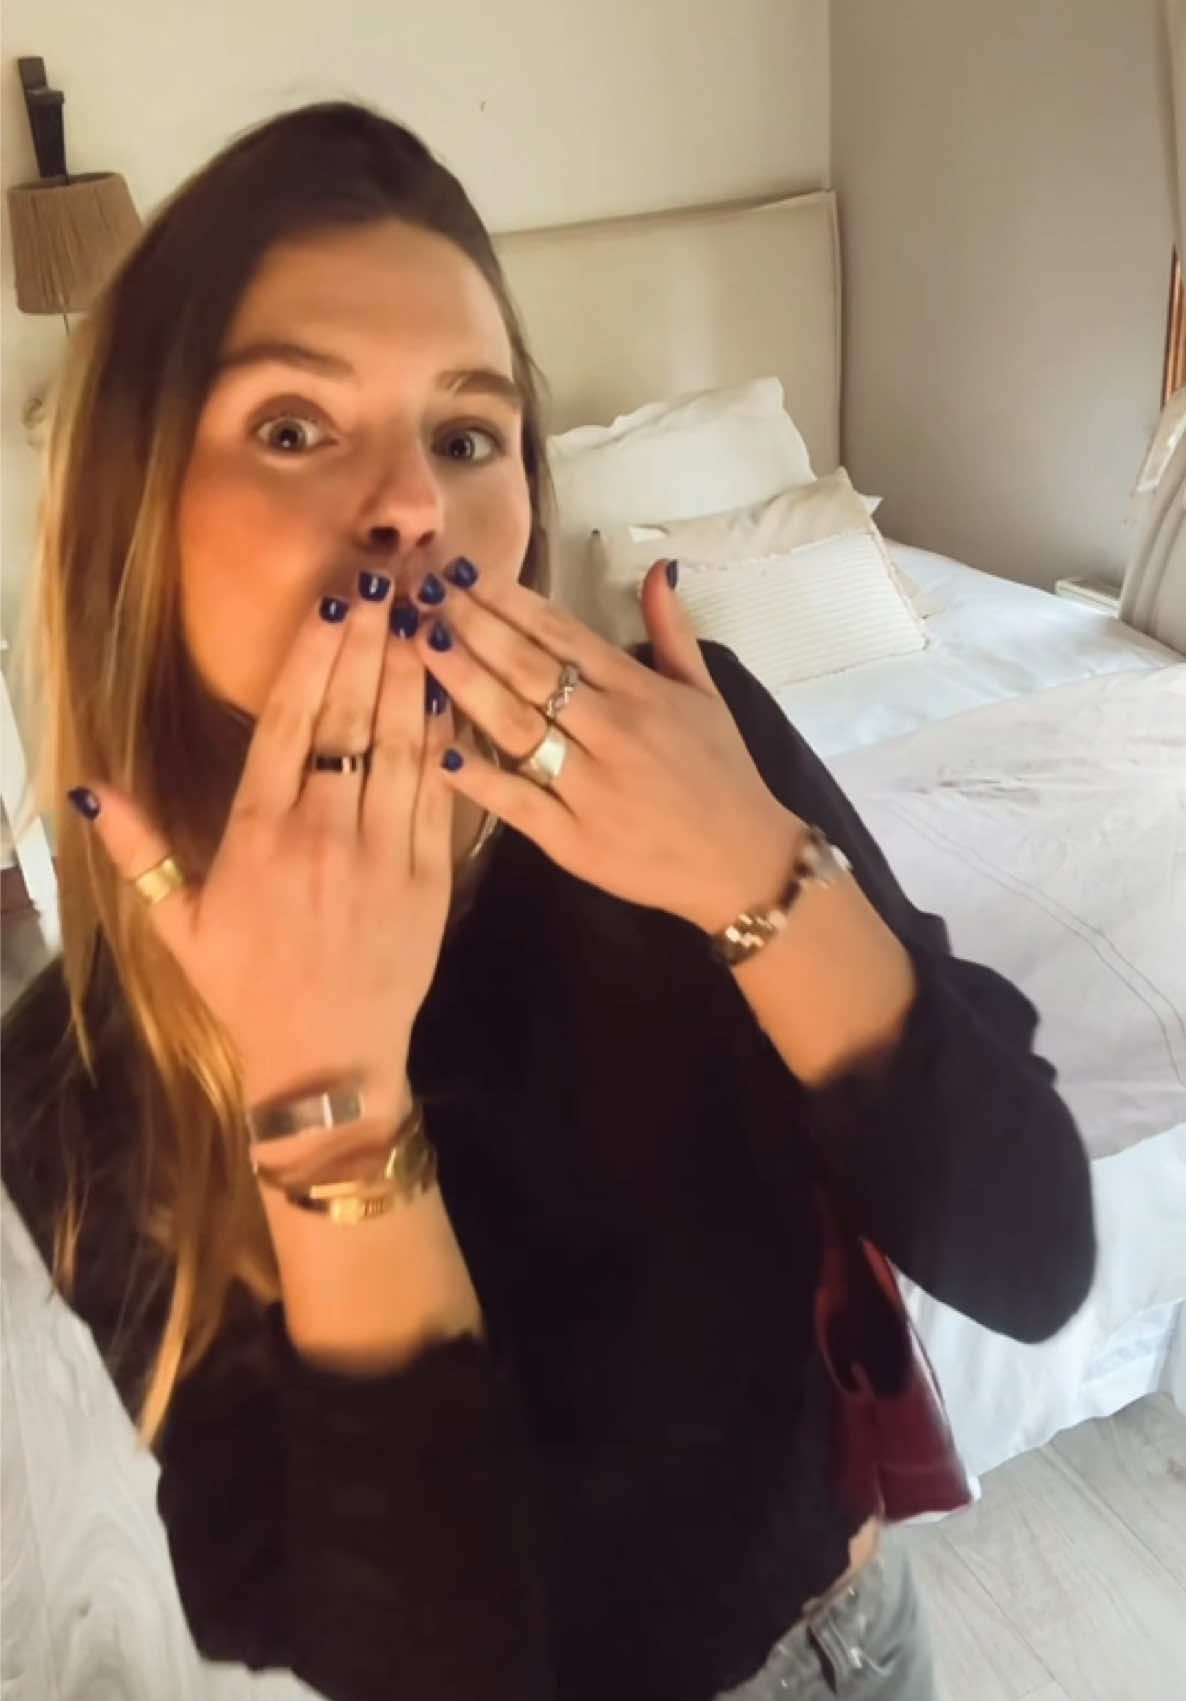
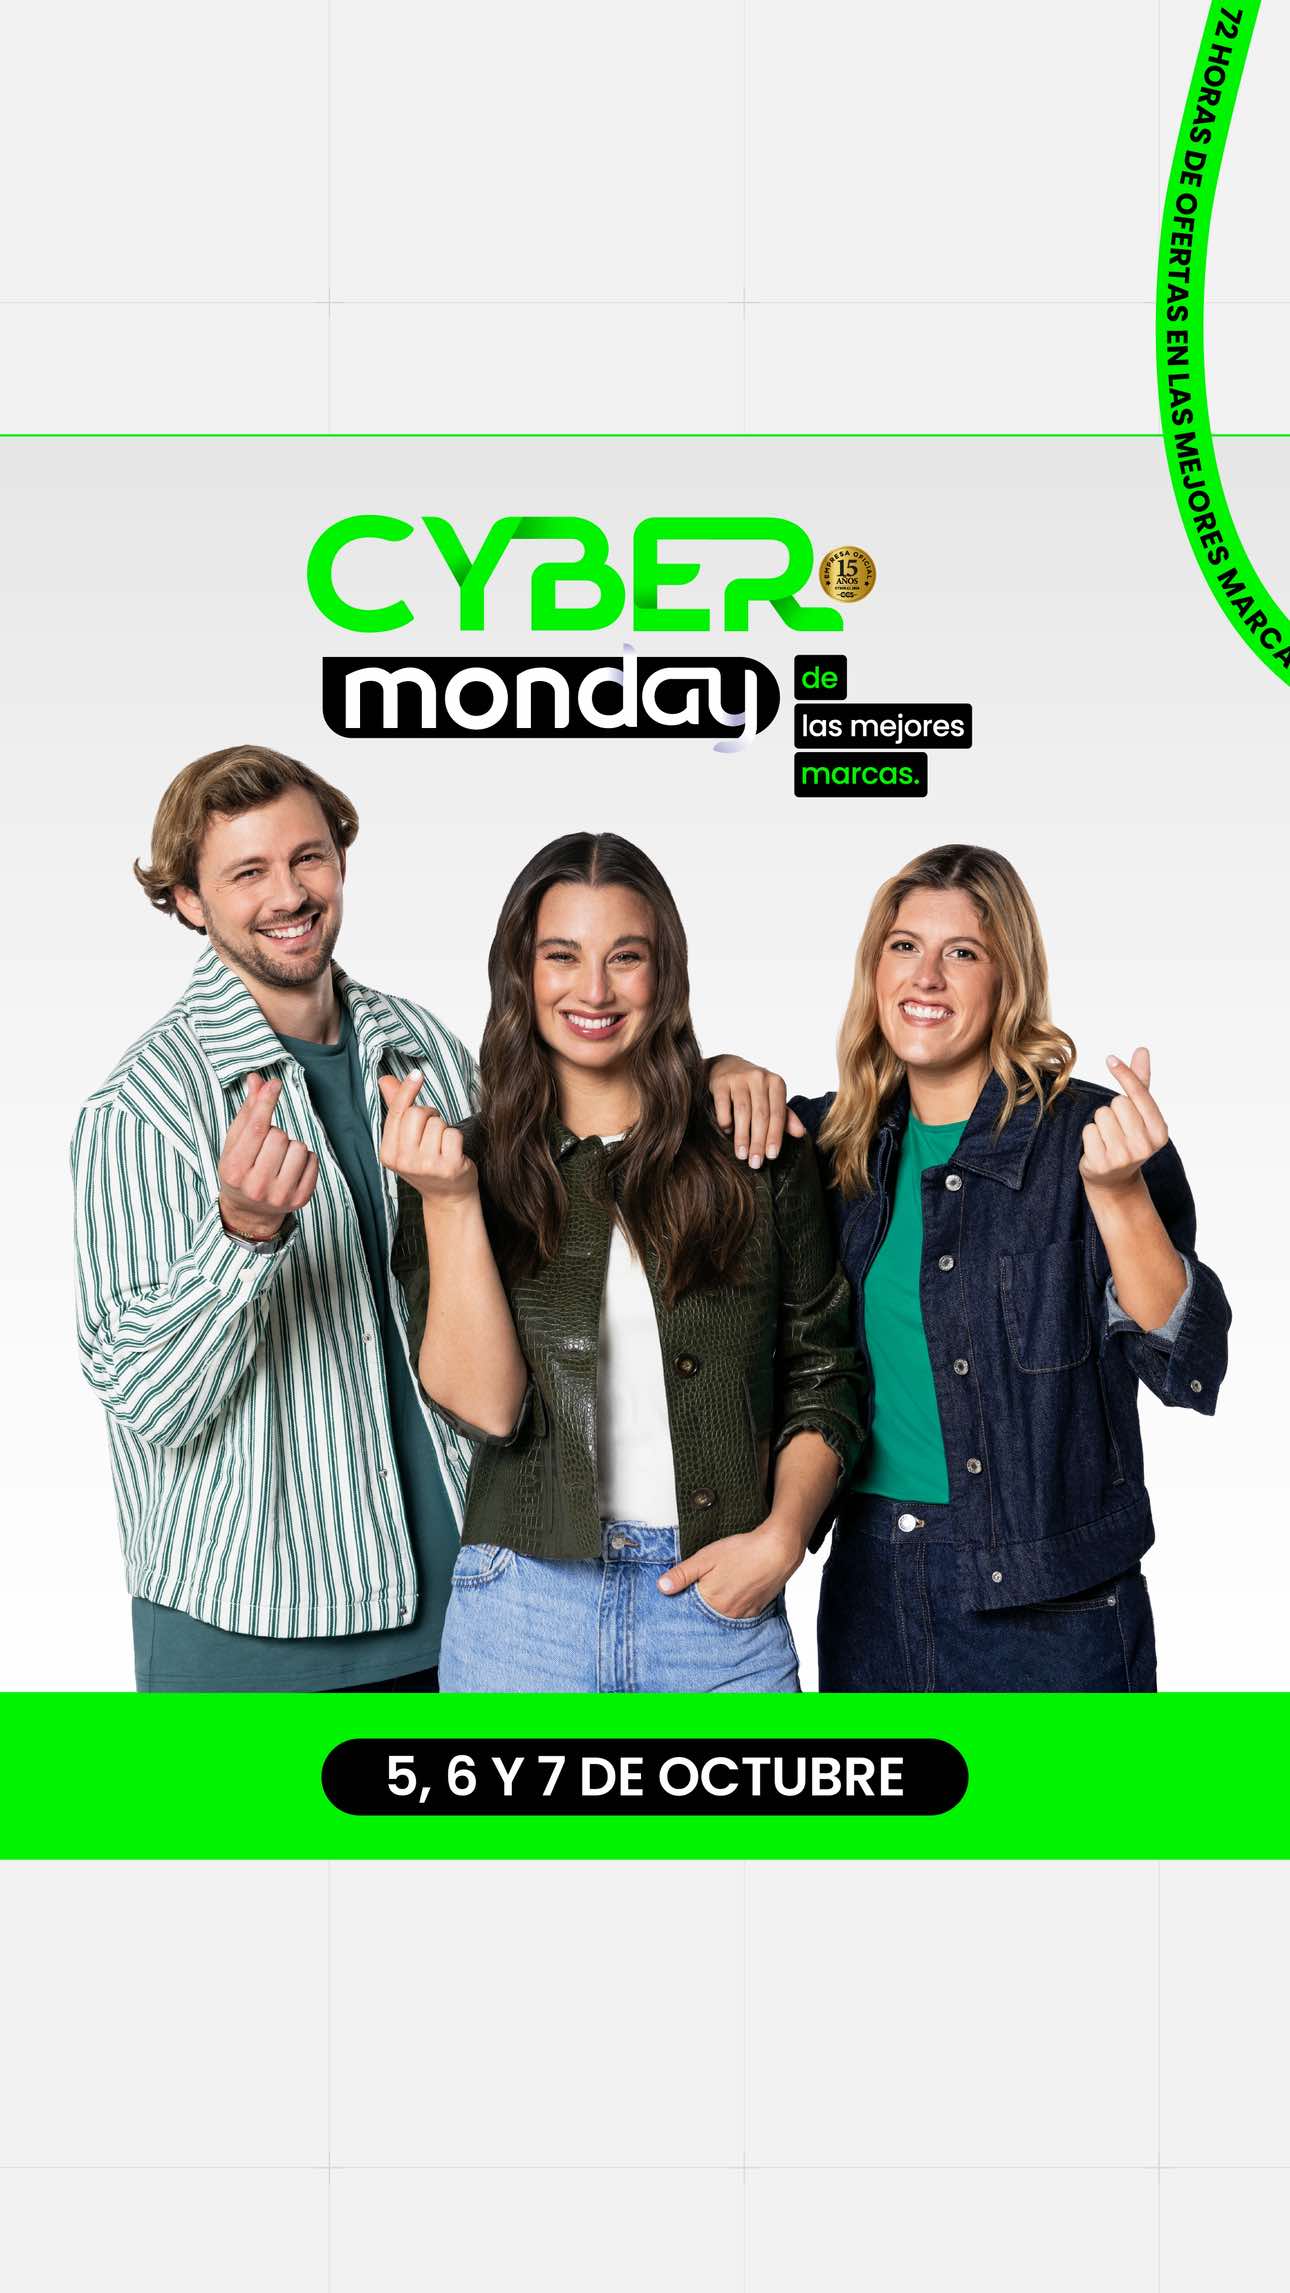
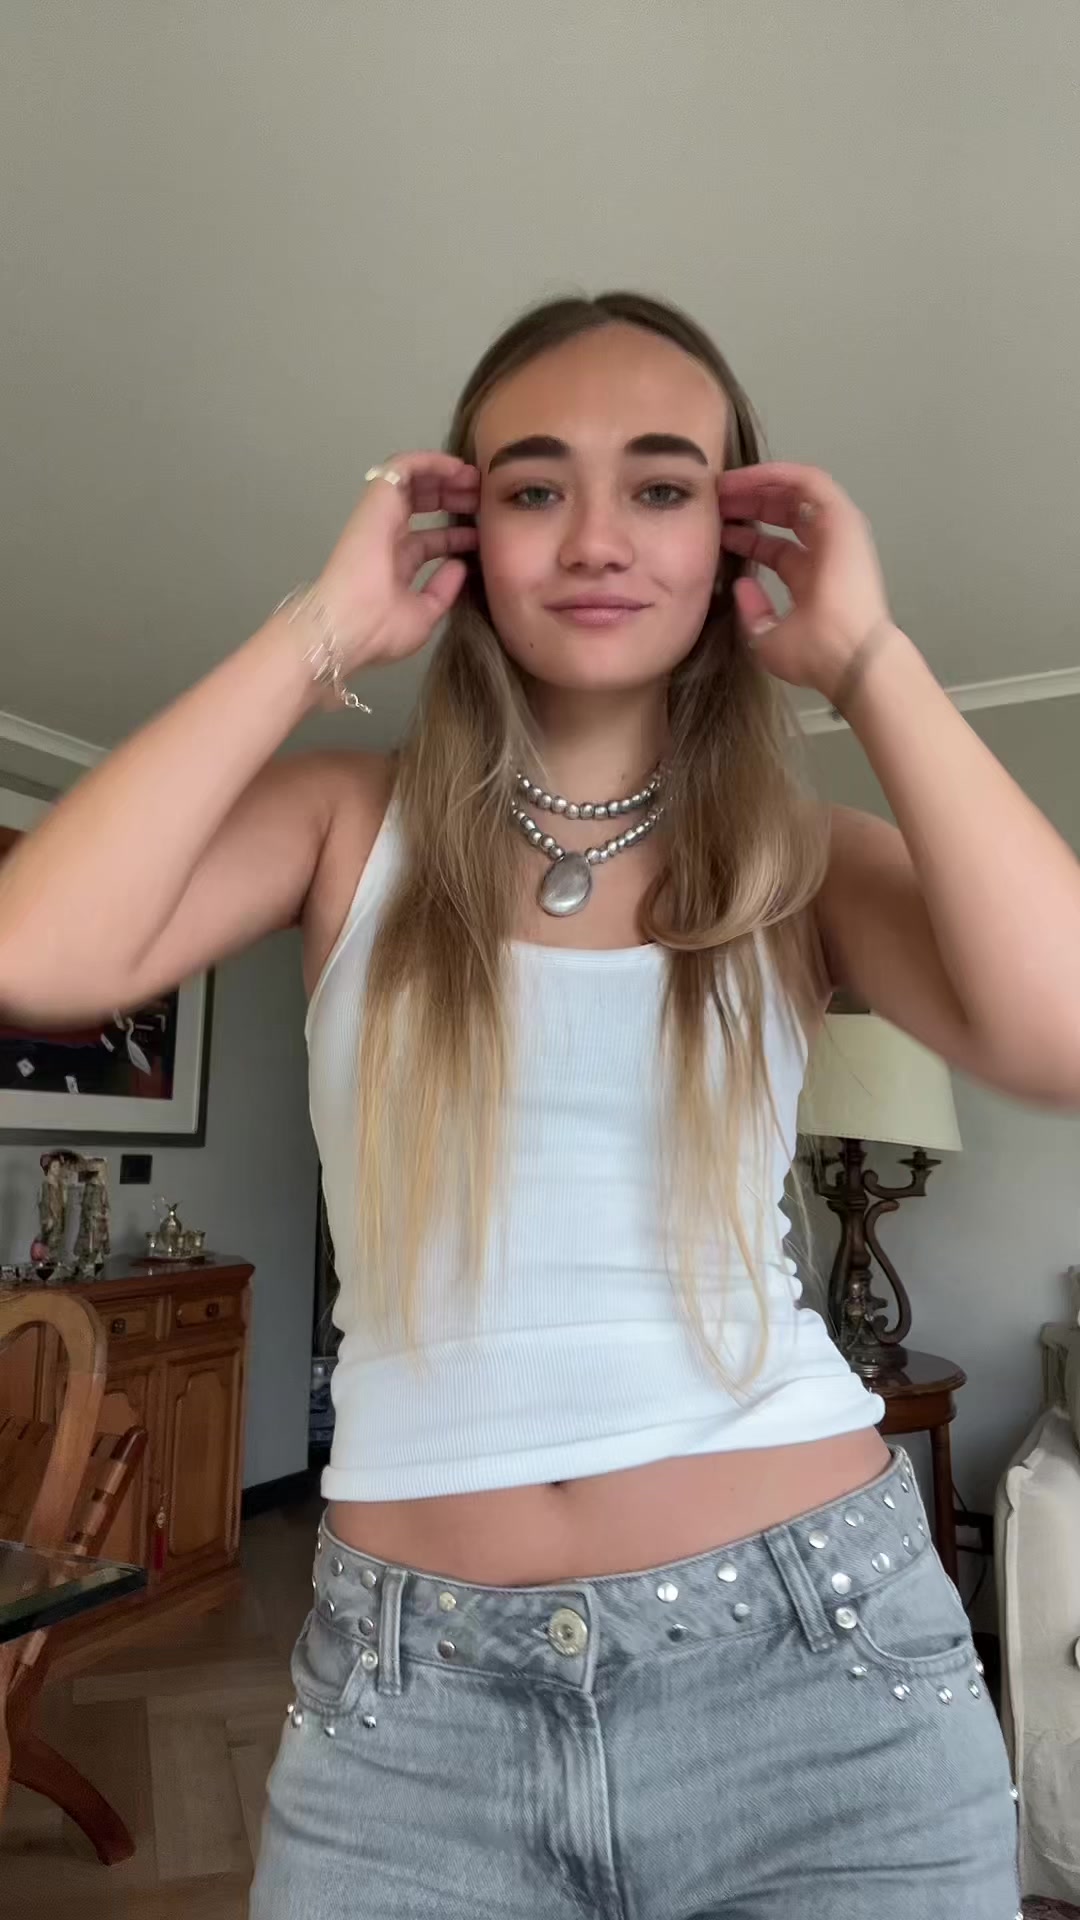
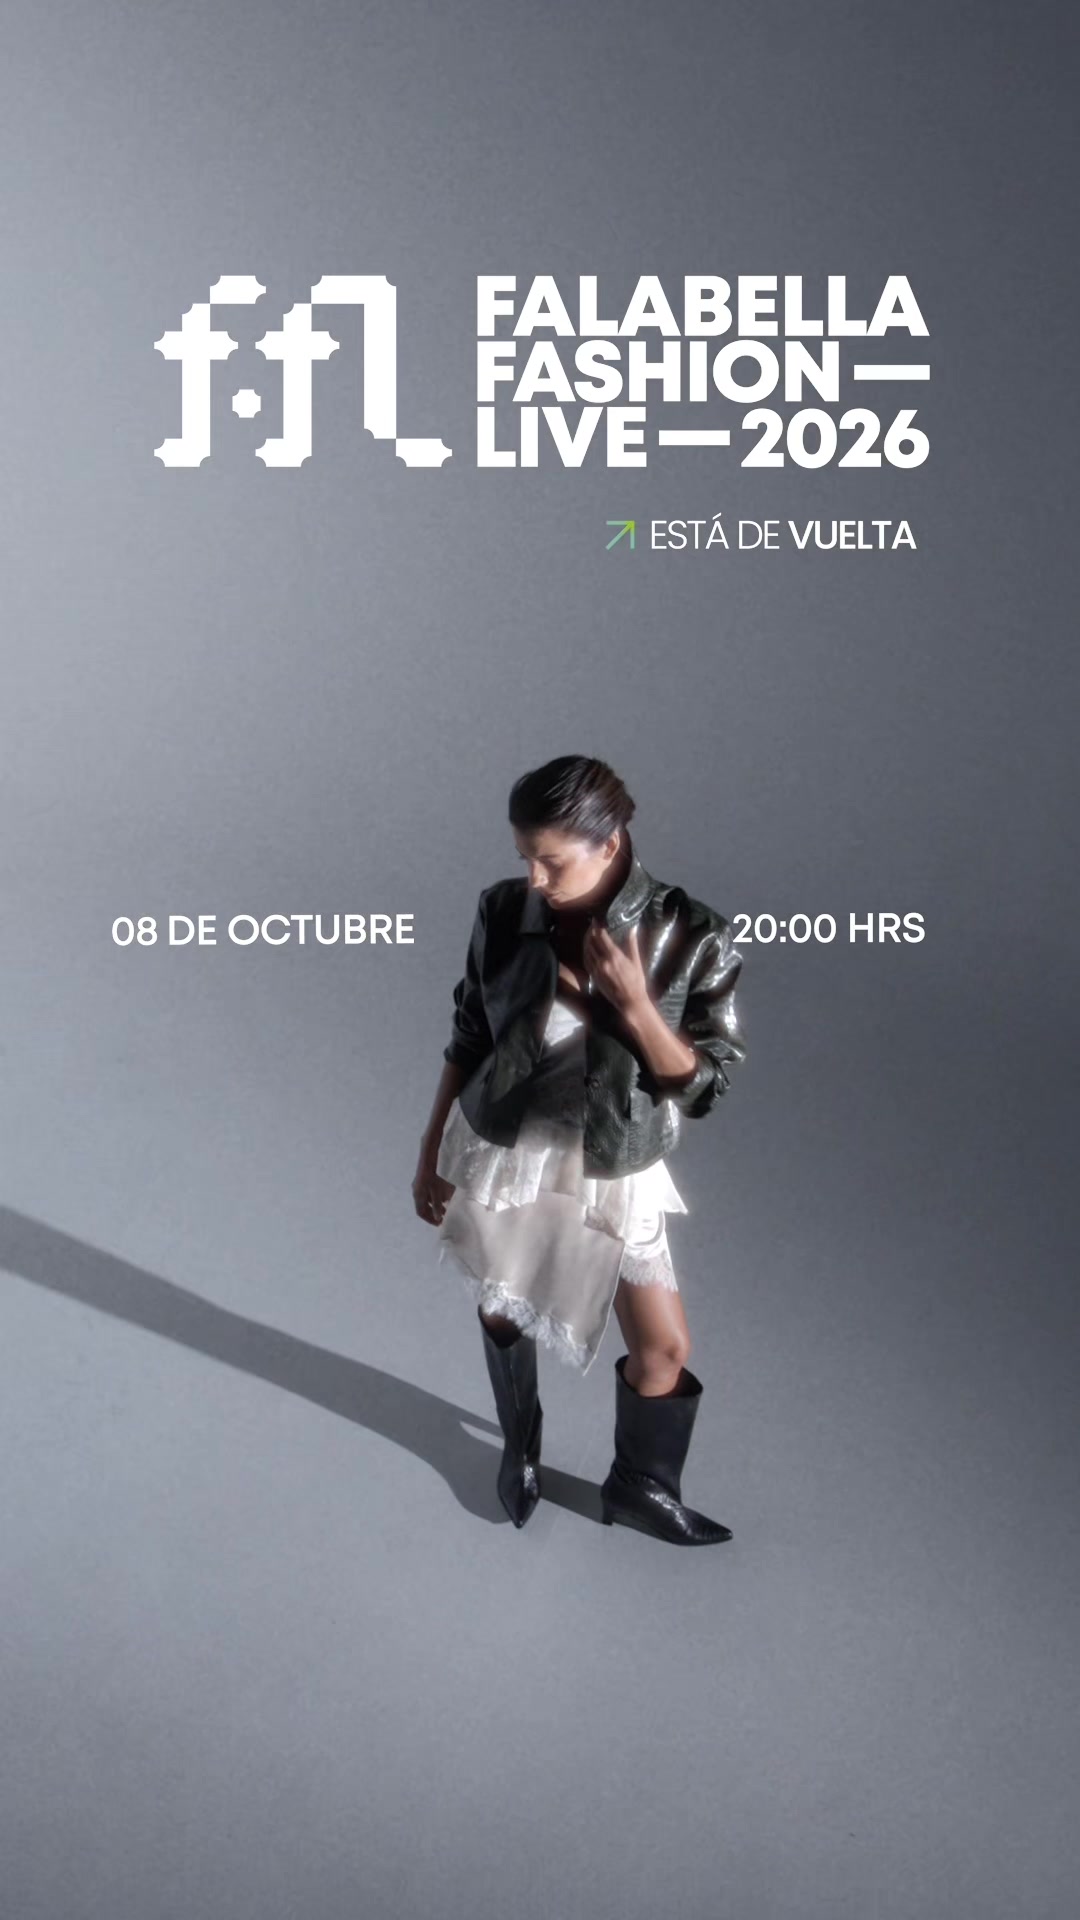
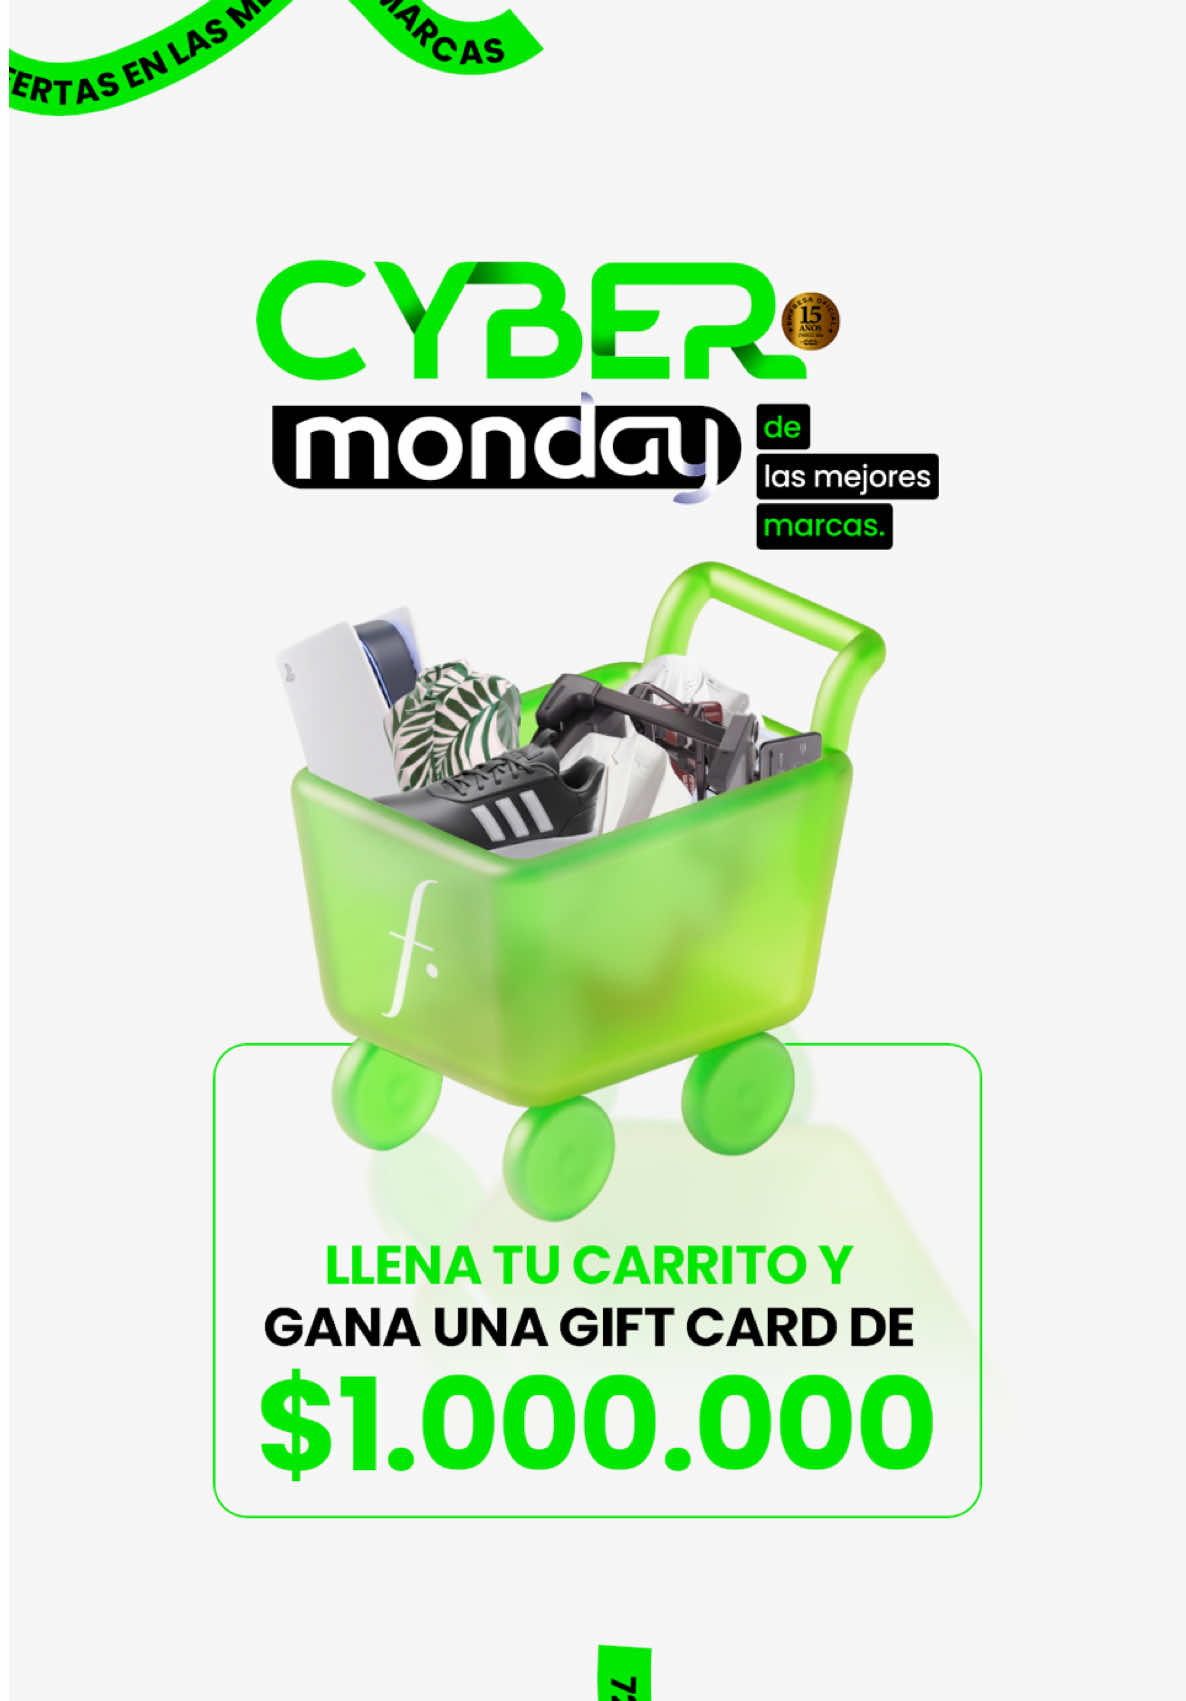
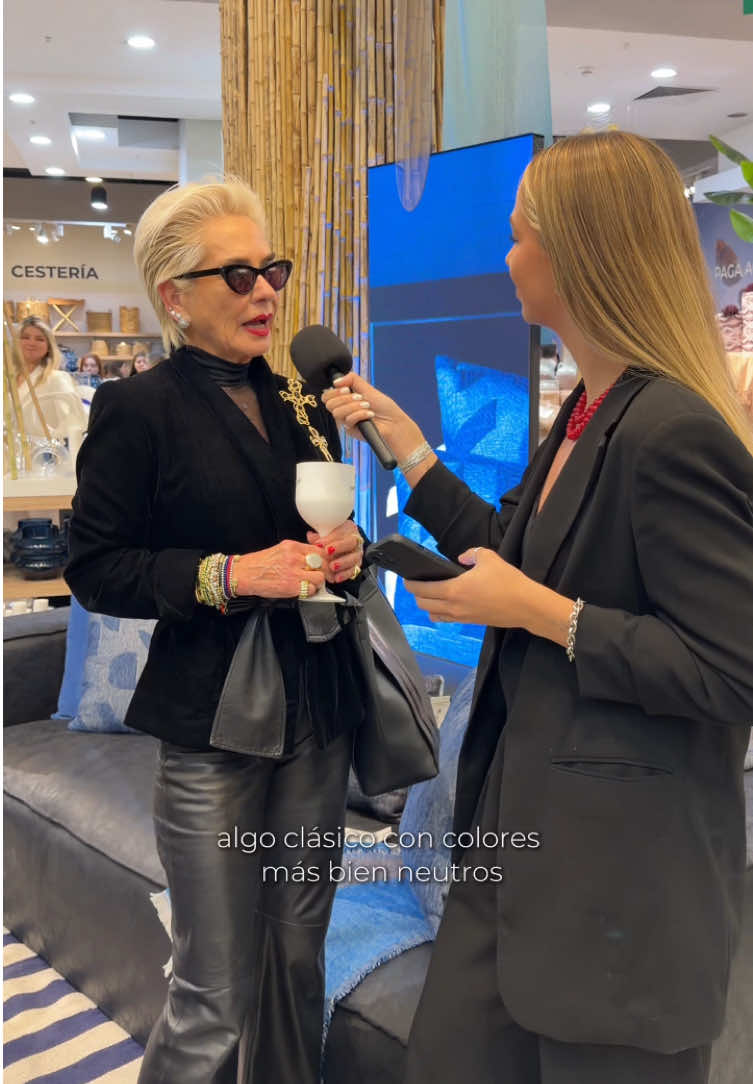
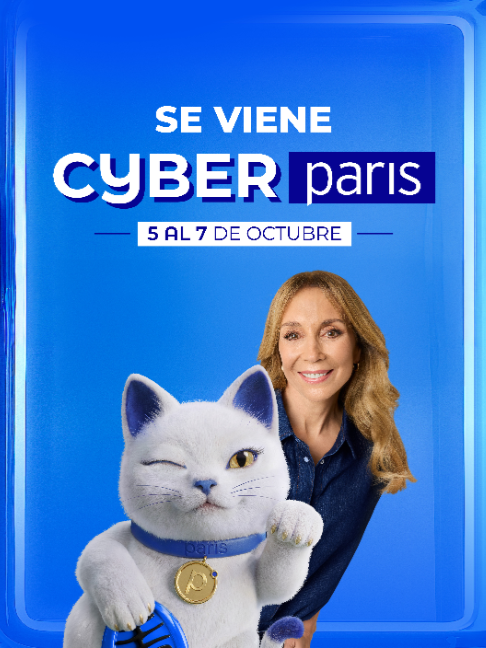
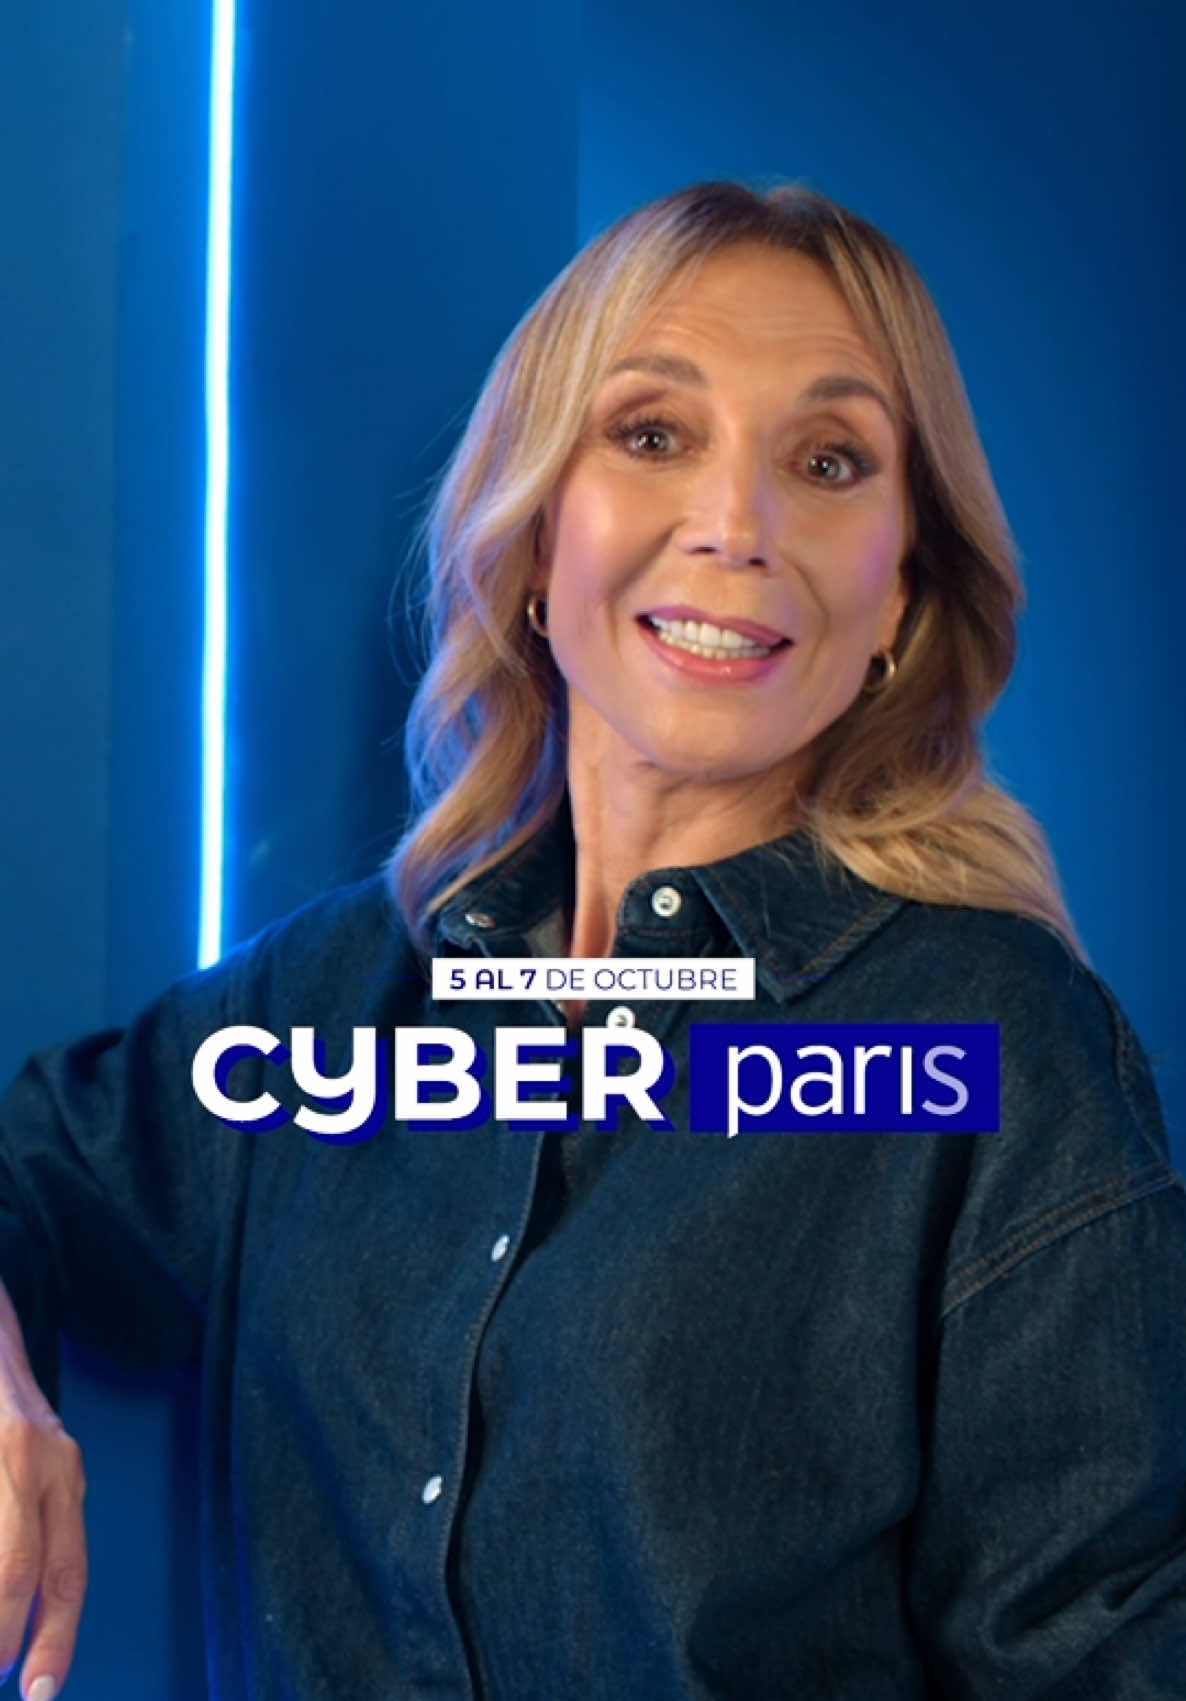
Piezas reales capturadas entre el 28 de septiembre y el 8 de octubre en Google Ads Transparency, Meta Ad Library y TikTok. Meta sólo expone la imagen mientras el anuncio sigue activo: las piezas de Meta que ves aquí son las que seguían corriendo el 8.
Porcentaje de creativos activos durante el evento que mencionan "Cyber", por plataforma. La línea es el ritmo de lanzamientos diarios en Meta entre el 28 de septiembre y el 7 de octubre.
Falabella44%30% Paris50%58%
 Ripley29%21%
 Lider22%64%
 Sodimac42%0%
 Mercado Libre96%0%
Lo que cada retailer tenía encendido en cada plataforma al cierre del evento. "Vida" es la fracción de piezas lanzadas en los días previos que seguían activas el 7 de octubre.
GoogleTikTokGoogleTikTokGoogleTikTokGoogleTikTokGoogleTikTokGoogleTikTokDeja tu correo y se abre el resto: el cuadro Jev / Clef por marca y canal, las piezas montadas por tema, las vistas en TikTok y el "¿y ahora qué?" post Cyber. Te mandamos el acceso y el CSV agregado.
Sin spam: el acceso, tres correos con la lectura y, si quieres, el observatorio sobre tu marca.Lo que acabas de abrir es el resumen. El reporte completo de este Cyber incluye todo esto:
Pedido. Te escribimos al correo que dejaste con el acceso y el pago.
Guardado. Gracias.
No son chats ni resúmenes. Son modelos de decisión: reciben el texto de una pieza y una pregunta cerrada, y devuelven una respuesta tipada con su probabilidad. Dos lectores que no comparten modelo ni proveedor, para que el acuerdo entre ambos sea la medida de confianza, no nuestra opinión.
 Jevtypesafe/jev-1.13 · TypeSafe AI · vía OpenRouter
Modelo de decisión entrenado para leer intención: qué está pidiendo un mensaje, una búsqueda o un anuncio. Acá lee el texto de cada creativo y reparte la probabilidad entre tres etapas.
 Clef@cf/cloudflare/clef · Cloudflare Workers AI
Modelo abierto (Apache 2.0) de 27B parámetros que corre en el edge de Cloudflare. Recibe exactamente las mismas preguntas, en el mismo formato, porque su API es compatible con la de Jev. Cuando los dos coinciden, la lectura se sostiene; cuando difieren, la diferencia es el dato.
Dos mediciones publicadas por los propios proveedores, con la salvedad de que cada uno corrió la suya. Sirven para dimensionar, no para elegir ganador.
| Benchmark | Clef | Clef-flash | Jev |
|---|---|---|---|
| CLINC150 + OOS intención, macro-F1 | 97,4 | 66,8 | 89,3 |
| BANKING77 intención, macro-F1 | 94,2 | 90,9 | 79,7 |
| API-Bank exactitud | 91,9 | 93,1 | 88,2 |
| Latencia mediana ms por decisión | 209 | 39 | 524 |
| Modelo | Intención | Escalación | p50 | US$ / 1.000 |
|---|---|---|---|---|
| Jev 1.13 | 98,3% | 100% | 194 ms | 0,025 |
| GPT Luna | 98,3% | 100% | 1.106 ms | 0,092 |
| Claude Opus | 100% | 98,3% | 1.957 ms | 2,880 |
Más fuentes: qué es Jev (OpenRouter), anuncio de Clef (Cloudflare), comparativa independiente y JevOut (arXiv). Ninguna de estas pruebas usa creativos publicitarios: por eso corremos los dos modelos sobre las mismas piezas y medimos el acuerdo.
Cada pieza se clasificó por la acción que pide. Falabella y Ripley hablan a quien ya decidió; Paris, Lider y Sodimac todavía están abriendo la puerta. Cambia de canal y de modelo para ver si la lectura se sostiene.
Qué argumento principal usa cada pieza. Paris, Lider y Sodimac venden el evento; Falabella, Ripley y Mercado Libre venden el número.
Fracción de piezas con señal de urgencia explícita. Google es el canal del apuro; en Meta casi nadie lo usó, salvo Ripley y Falabella.
GoogleDe las piezas lanzadas el 4 y 5 de octubre en Meta, cuántas seguían activas el 7. En Google, cuántas de las nuevas del periodo tuvieron su última exhibición el mismo 7 de octubre.
Falabella43%de 635Paris46%de 1119Ripley37%de 262Lider18%de 55Sodimac56%de 184Mercado Libre98%de 310Falabella lanzó 233 piezas el 4 y 5 y el 7 quedaban 115: la mitad apagada en 48 horas. Estrategia de ráfaga.
Paris mantuvo 312 de 369 encendidas. No optimizó por pieza: dejó que el algoritmo eligiera dentro del set.
Lider cambió todo el día 3: 170 piezas nuevas y solo 18 sobrevivientes. Una campaña distinta para el cierre.
Volvimos a capturar el 8 de octubre a las 08:35, con el evento cerrado. De las piezas activas el 7, cuántas seguían el 8 en Meta y en Google, cuántas nuevas aparecieron y cuántas todavía decían Cyber.
Falabella94%siguen de 2.840 · 8 nuevasParis96%siguen de 1.011 · 12 nuevasRipley86%siguen de 1.777 · 9 nuevasLider93%siguen de 176 · 2 nuevasSodimac96%siguen de 1.358 · 0 nuevasMercado Libre94%siguen de 21.620 · 0 nuevasParis apagó 398 de 407 piezas de Meta en una noche y lanzó 115 nuevas: ninguna dice Cyber. El cierre más limpio de las seis.
Lider terminó con más piezas que durante el evento: 251 contra 231, con 78 nuevas y cero Cyber. Volvió al always-on sin pausa.
Mercado Libre es el único que siguió diciendo Cyber el 8: 14 piezas nuevas con la palabra. La "extensión" no apareció en ninguna marca, ni en Meta ni en Google.
Piezas reales de Google Ads del periodo con la lectura completa de los dos modelos. "Texto leído" es lo que el OCR sacó de la imagen (o el texto del anuncio, cuando es un anuncio de texto): es exactamente lo que recibieron Jev y Clef. Las barras de intención reparten el 100% entre las tres etapas; las demás muestran la probabilidad de la respuesta.
Falabella3 piezas · GoogleJevClef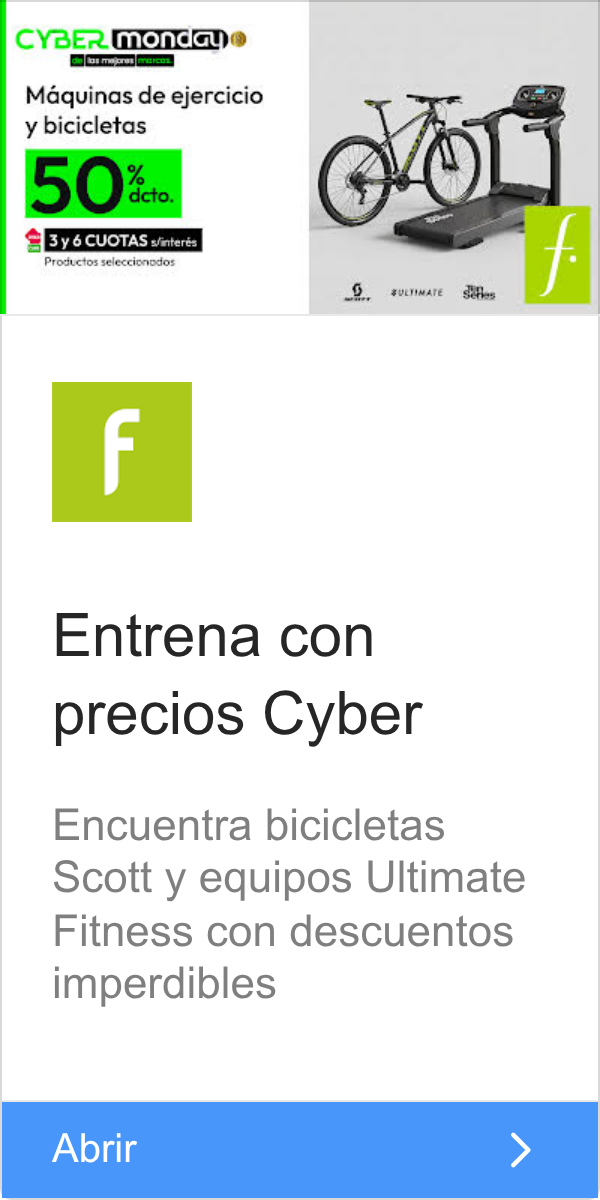 JevClef
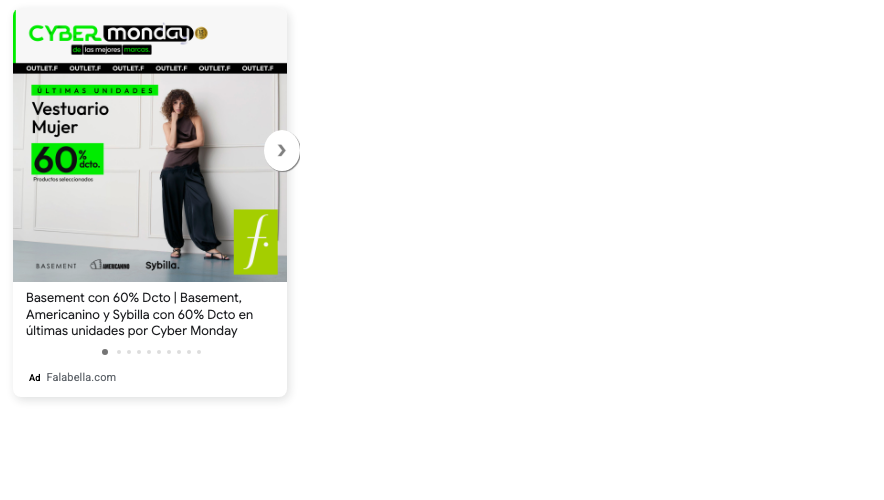 JevClefParis3 piezas · Google
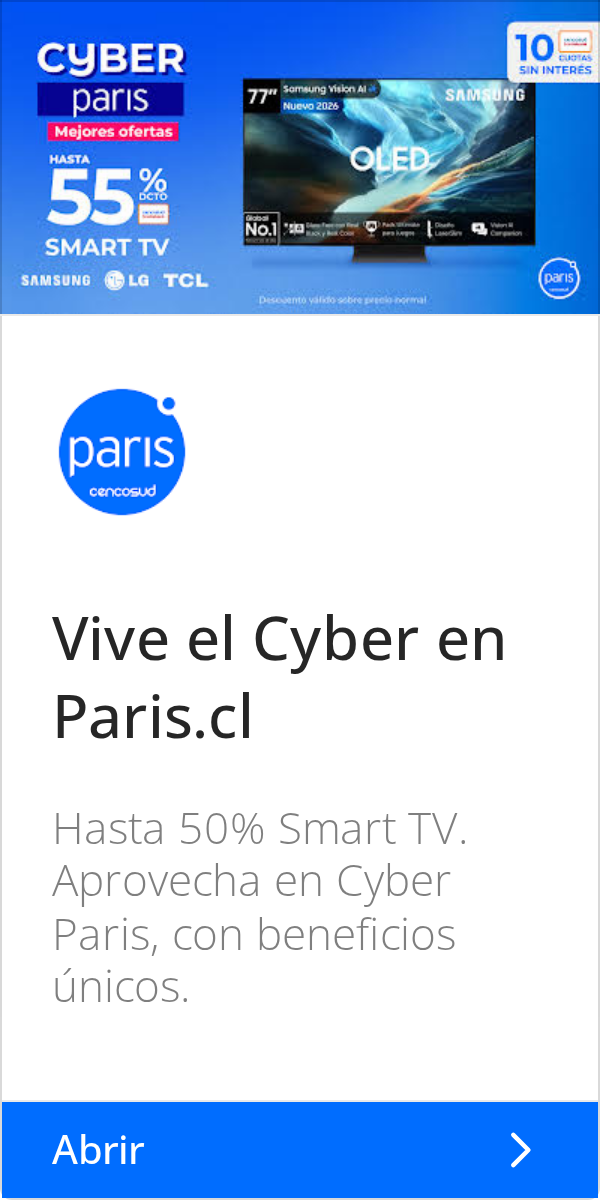 JevClefJevClef
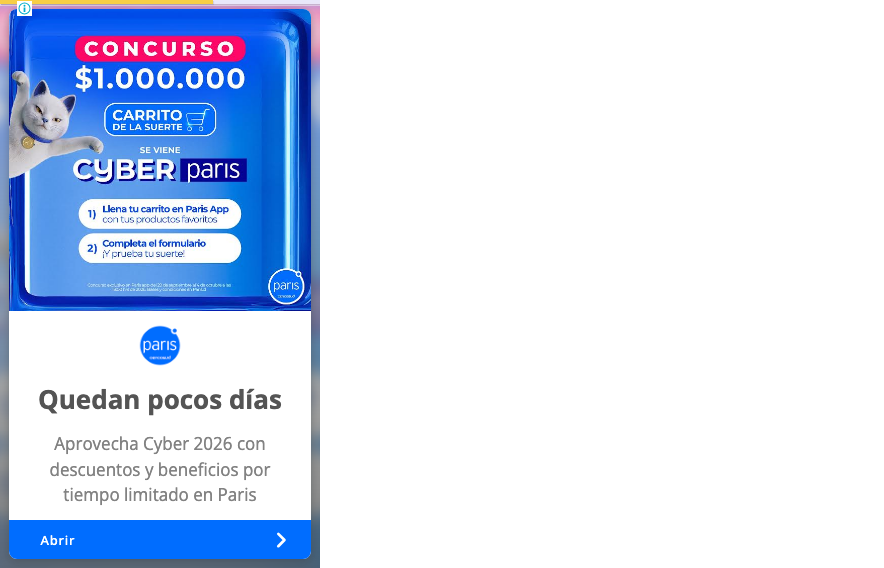 JevClefRipley3 piezas · GoogleJevClef
 JevClef
 JevClefLider3 piezas · GoogleJevClefJevClefJevClefSodimac3 piezas · GoogleJevClef
 JevClefJevClefMercado Libre3 piezas · Google
 JevClef
 JevClef
 JevClef
Vistas acumuladas de los posts del periodo, separando pauta de orgánico con el flag isAd: un campo que TikTok publica en cada post, no una inferencia nuestra. Falabella y Paris sumaron más vistas, pero con contenido de expectativa. Lider fue la única cuyo post principal empujó a cerrar: el carrito listo hizo 6,8 millones de vistas y la marca sumó 6,2 millones entre la captura del 5 y la del 7 de octubre.
isAdFalabella"La cuenta regresiva ya comenzó. 👀 Las mejores marcas se preparan para el Cyber Monday de …" · 11,7 M vistas
+1,1 M entre capturasisAdParis"¡Atención! 🐾 El gato de la suerte y Karen ya están afinando los últimos detalles porque… …" · 4,6 M vistas
+4,6 M entre capturasorgánicoRipleyisAdLider"Yo dejando el carrito listo como si el Cyber empezara en 10 minutos 👀🛒🔥 No me interrump…" · 6,8 M vistas
+6,2 M entre capturasisAdSodimac"¿Tu jardín necesita renovarse 🌿☀️ Con las herramientas adecuadas, puedes pasar de la mal…" · 497 K vistas
+146 K entre capturasLo que se repite cuando pones las piezas una al lado de la otra. Creativos de Google Ads del periodo, agrupados por el argumento que llevan impreso.
Descuento máximo en grande y el resto en letra chica. Falabella y Ripley lo llevan al extremo: la pieza es el número.
CMR, Cencosud y Ripley Card entran en el creativo como condición del descuento. El Cyber vende también el plástico.
Gratis, hoy, en tienda. Aparece sobre todo en Google, donde el creativo tiene que resolver la objeción logística en un segundo.
Descarga la app, arma el carrito, participa. Lider y Paris usaron el Cyber para instalar hábito, no solo para vender.
Sobre 3.899 creativos de Meta, Google y TikTok coincidieron en intención el 87%, en palanca el 81% y en urgencia el 95%. Por canal, el acuerdo en intención fue 84% en Meta, 88% en Google y 95% en TikTok. Las diferencias dicen más que los promedios.
JevListo · ClefUrgencia · JevUrgencia · ClefFalabella71%71%15%9%Paris26%16%2%1%Ripley47%57%19%11%Lider15%20%14%2%Sodimac9%11%11%11%Mercado Libre6%4%0%0%Piezas leídas como Cyber en Meta. Acuerdo Jev / Clef en intención: 84% sobre 1.440 piezas.
JevListo · ClefUrgencia · JevUrgencia · ClefFalabella56%58%27%24%Paris35%47%44%39%Ripley63%59%16%10%Lider64%60%14%10%Sodimac49%50%21%15%Mercado Libre4%2%1%0%Piezas leídas como Cyber en Google Ads. Acuerdo Jev / Clef en intención: 88% sobre 2.398 piezas.
JevListo · ClefUrgencia · JevUrgencia · ClefFalabella0%0%15%15%Paris0%8%25%25%Ripley13%6%13%13%Lider9%9%46%36%Sodimac0%0%0%0%Mercado LibreSin piezas en TikTok durante el periodoLos 61 posts del periodo, con y sin Cyber. Acuerdo Jev / Clef en intención: 95% sobre 61 piezas.
En Meta, Jev ve un 26% listo para comprar; Clef, un 16%. Paris escribe piezas de evento que un lector exigente lee como "todavía no": la misma pieza es compra o exploración según quién la mire.
En Meta, Clef casi nunca ve urgencia (5% vs 9%). Lo que Jev llama "último día", Clef lo clasifica como evento. Para una marca eso importa: la urgencia implícita no se mide igual que la explícita.
La mañana del 8 de octubre Paris había apagado 398 de sus 407 piezas de Meta y Lider ya corría 78 nuevas sin la palabra Cyber. Nadie lo convirtió en "extensión". Black Friday y Navidad se miden con el mismo método, y ahí los que tienen la app y el carrito instalados parten con ventaja.
Jev y Clef leen la misma pieza con la misma pregunta. Cuando coinciden, la lectura se usa. Cuando difieren, la pieza pasa a una persona. El experimento no es qué modelo gana: es dónde lo que interpreta un humano se separa de lo que clasifica la IA, empezando por la clasificación misma.
Intención 87%, palanca 81%, urgencia 95% de acuerdo sobre 3.899 piezas de Meta, Google y TikTok. Esa lectura entra al estudio tal cual, con la probabilidad de cada modelo.
La pieza es ambigua y la revisa una persona. En este estudio pasó con Paris (26% listo para comprar según Jev, 16% según Clef) y con la urgencia (9% contra 5%): piezas de evento que un lector exigente lee como "todavía no".
Las cinco preguntas y sus categorías las definió una persona con criterio de medios; el modelo solo reparte probabilidad. Cada ronda del observatorio compara una muestra leída a mano contra las dos lecturas y ajusta las definiciones. Lo que se afina es el criterio, no el modelo.
Todos esos modelos pueden clasificar una pieza si se les pide. Ninguno está hecho para hacerlo 3.899 veces con la misma vara. Nuestra elección es el especialista: un partner tecnológico capaz de responder una pregunta cerrada con una probabilidad calibrada, rápido y a bajo costo. Modelos de decisión como Jev y Clef cumplen ese estándar.
| Criterio | LLM general Claude, ChatGPT, Gemini, Perplexity, Grok, Copilot | Modelo de decisión Jev, Clef |
|---|---|---|
| Para qué está hecho | Conversar, redactar, razonar en texto libre. | Clasificar: una pregunta cerrada, una respuesta tipada. |
| Qué devuelve | Prosa que hay que parsear; el formato cambia con el prompt. | Una opción y su probabilidad, siempre con la misma estructura. |
| Confianza | La que diga el texto. No está calibrada ni es comparable entre piezas. | Calibrada: 0,8 significa que acierta cerca de ocho de cada diez. |
| Latencia por pieza | De 0,8 a 2,1 segundos en el benchmark de OpenRouter. | Cerca de 200 ms. Las 3.899 piezas se leen en minutos. |
| Costo por 1.000 lecturas | De US$0,09 a US$2,88 según el modelo. | De US$0,02 a US$0,05. |
| Repetibilidad | Varía con la temperatura y el prompt: dos corridas, dos lecturas. | Misma pieza, misma respuesta. Sirve para comparar semanas y marcas. |
| Segunda opinión | Comparar dos LLM generales compara dos prompts. | Jev y Clef responden la misma especificación: el acuerdo se mide directo. |
Los LLM generales sí sirven para escribir, resumir y explicar: este estudio se redactó con uno. Lo que no hacen bien es ser la vara con la que se mide cada pieza, todas las semanas.
Seis retailers, tres plataformas, 3.899 piezas y dos lectores que coinciden en lo importante: el descuento lo tenían todos. Lo que separó a unos de otros fue cuánto pedía cada pieza, cuánto duró encendida y qué quedó instalado después.
Falabella lanzó 233 piezas en dos días y apagó la mitad en 48 horas. No fue un error: fue lanzar mucho, medir rápido y dejar sólo lo que cierra. Es la marca con más "listo para comprar" en Meta.
369 piezas, nueve de cada diez con la palabra Cyber y 2% de urgencia. Clef lee sólo un 16% como compra. Nada se apagó porque nada se midió por pieza.
El único que llevó el carrito listo y la pauta marcada al canal donde los demás sólo calentaron. 6,8 millones de vistas con el flag isAd puesto.
26% de urgencia en Google contra 9% en Meta. El "último día" en el feed quedó vacío: para una marca mediana es el espacio más barato del evento.
Lo que sobrevive al Cyber no es el descuento. Es la app instalada, el carrito armado y la pieza con oferta concreta. Quien tenía eso el 4 de octubre parte con ventaja el 27 de noviembre. Quien compró la palabra, parte de cero.
Te hacemos llegar la misma lectura de creativos, con Jev y Clef, sobre el Black Friday 2026. El acceso al resumen del estudio es gratis. Si quieres los detalles por pieza y el acceso completo al estudio del próximo Black Friday, por tiempo limitado te damos una oferta por el reporte completo.
Listo. Tienes el acceso reservado; te avisamos antes del Black Friday con el reporte en preventa.
Fuentes públicas, dos capturas y dos modelos. Sin datos de inversión: nada en este estudio dice cuánto gastó nadie.
Google2.398 creativos nuevosTikTok61 postsJevClef